RTX Spark d’Asus : l’IA locale sans cloud, sur PC, mini-PC et portables ProArt
À l’IFA 2026, Asus place l’IA générative locale au centre de sa stratégie. Avec RTX Spark, l’objectif vise des agents capables d’agir sur vos fichiers, sans imposer un passage constant par le cloud.
Cette approche change la nature du déploiement : puissance locale, contexte conservé et pilotage plus direct. Voici ce qu’il faut comprendre, produit par produit, pour évaluer le potentiel réel.
A voir aussi : Zelda ocarina of time remake sur switch 2 : date, prix et nouveautés du microphone
En bref
- RTX Spark mise sur une exécution locale pour préserver le contexte et réduire la dépendance au cloud.
- Asus décline la plateforme en mini-PC Windows, station Linux et portables ProArt.
- La puce NVIDIA GB10 combine CPU Grace et GPU Blackwell avec une mémoire unifiée annoncée.
- Les logiciels locaux (ex. MuseTree, StoryCube) visent la génération, l’indexation et l’orchestration.
- Les modèles, jusqu’à des ordres de grandeur de 120 milliards de paramètres, restent conditionnés à la taille des contextes et des workflows.
RTX Spark : que change vraiment l IA qui tourne chez vous ?
RTX Spark vise une exécution à domicile, avec un traitement local des entrées et des sorties. L’enjeu porte sur le contexte : un agent qui comprend vos données doit éviter leur transfert systématique. Asus met aussi en avant l’absence de facturation liée au volume de requêtes.
Lire également : Muse de meta : l’ia autonome qui planifie vos voyages, organise vos e-mails et gère vos achats
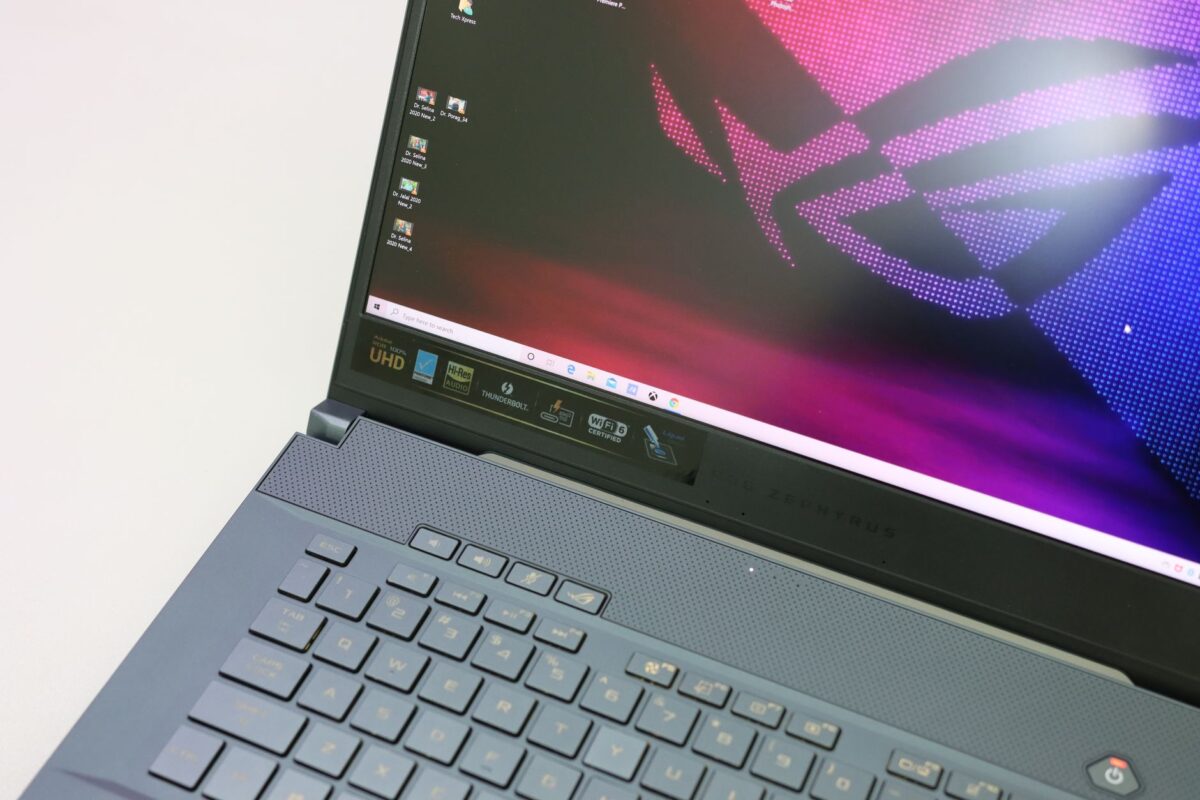
Le dispositif s’appuie sur la puce NVIDIA GB10, réunissant Grace et Blackwell sur une même base. Selon les annonces, l’ensemble viserait jusqu’à 128 Go de mémoire unifiée et des charges de calcul adaptées à des modèles lourds.
Comment la puce NVIDIA GB10 pilote la charge des modèles lourds
La puce NVIDIA GB10 est présentée comme un socle hybride, pensé pour limiter les frictions entre CPU et accélération GPU. L’intérêt se voit dans la capacité à enchaîner génération d’images, transformation vidéo et manipulation de données volumineuses.
Asus annonce une puissance de l’ordre du 1 PetaFLOP en FP4 et évoque des modèles jusqu’à 120 milliards de paramètres. En pratique, la faisabilité dépend de la taille des contextes, des formats et des contraintes mémoire d’un workflow.
Pour mieux situer les repères, voici des éléments de décision fréquents à vérifier avant de choisir un matériel :
- Mémoire unifiée disponible pour le modèle et le contexte, pas seulement pour l’inférence.
- Précision (ex. FP4) et impact sur la qualité perçue, selon le type de tâche.
- Débit vidéo visé et temps de rendu, car la génération réelle dure plus longtemps que la démo.
- Refroidissement et niveaux sonores, car l’IA locale fonctionne souvent en continu.
| Élément | Ce que l’annonce suggère | Ce qu’il faut tester en conditions réelles |
|---|---|---|
| Mémoire | Jusqu’à 128 Go de mémoire unifiée | Contexte long, garde de caches et stabilité sur plusieurs runs |
| Calcul IA | Ordres de grandeur en FP4 | Qualité vs vitesse sur vos prompts et vos formats de données |
| Localité | Traitement sans dépendance permanente au cloud | Orchestration d’agents et gestion des dépendances logicielles |
ProArt GR1X : un mini-PC Windows pour des agents toujours prêts
Le ProArt GR1X cible une logique d’agent permanent sur Windows 11. Asus le décrit avec une stratégie de continuité : l’idée n’est pas de lancer l’IA à la demande, mais de maintenir un environnement prêt pour des tâches récurrentes.
Le châssis serait optimisé pour tenir une charge annoncée jusqu’à 140 W en continu, même autour de 35 °C. Le constructeur évoque aussi un niveau sonore de l’ordre de 31-32 dB, utile pour une utilisation dans une pièce de travail.
Ascent GX10 sous Ubuntu : station locale pour développeurs et orchestration
L’Ascent GX10 sert de pendant Linux au GR1X. Asus le positionne pour les développeurs, avec la possibilité d’assembler plusieurs unités, jusqu’à x4, selon des besoins de calcul. L’approche vise la reproductibilité d’un environnement d’expérimentation.
Asus insiste sur une séparation claire entre les deux gammes : le GR1X et le GX10 ne seraient pas interchangeables. Cette distinction compte si vous déployez des agents, car les dépendances système et les pilotes peuvent influer sur la stabilité.
ProArt P16 et P14 : l IA locale en déplacement pour la création
Les ProArt P16 et ProArt P14 prolongent l’idée de localité dans un format portable. Asus mise sur des dalles très exigeantes, car l’édition vidéo et la retouche 3D demandent souvent à la fois calcul et rendu visuel.
Le P16 viserait une épaisseur d’environ 12,9 mm et un poids d’environ 1,77 kg. L’annonce inclut une dalle OLED 4K jusqu’à 1600 nits, avec un calibrage Delta E inférieur à 1 et un rafraîchissement jusqu’à 120 Hz.
Le P14 reprend une logique proche avec une dalle 3K tactile et un poids annoncée d’environ 1,48 kg. Les deux portables mentionnent une connectique complète et deux emplacements SSD PCIe Gen 5, point important pour les fichiers volumineux.
Exemples concrets d’usage par profil, pour juger la pertinence :
- Motion designer : génération d’images en local puis enchaînement d’export vidéo, sans attendre un lien réseau stable.
- Développeur d’agents : prototypage d’actions sur des fichiers locaux, avec un contrôle direct des dépendances et des logs.
- Studio photo : indexation et ré-attribution d’archives via StoryCube, tout en conservant les métadonnées sur site.
Quels logiciels exploitent RTX Spark sans dépendre du cloud ?
Asus présente une suite pensée pour l’usage local. MuseTree traiterait la génération d’images et de vidéos en local, en s’appuyant sur des variantes annoncées comme Flux 2.0 pour l’image et WAN 2.2 pour la vidéo.
StoryCube serait chargé d’indexer et de retrouver des contenus, tandis que Creator Hub agirait comme tableau de bord. Une logique “répartition” serait aussi évoquée via un mode Zeny Cloud modulable, selon le besoin.
Une précaution d’interprétation s’impose. Les démos montrent des parcours courts, alors que vos tâches réelles incluent souvent nettoyage de données, validations et itérations longues.
Erreurs fréquentes à éviter quand vous migrez vers l IA locale
Les projets IA locaux échouent rarement à cause de la puissance brute. Ils échouent le plus souvent par mauvaise estimation du contexte, du temps de calcul et des contraintes d’usage. Une adoption progressive réduit les déceptions et améliore la qualité de résultats.
Voici les erreurs à surveiller avant d’organiser des agents sur vos machines RTX Spark :
- Confondre inférence et “usage complet” : l’agent doit aussi gérer fichiers, droits et historisation.
- Sous-estimer le contexte : des instructions longues augmentent la mémoire et le temps de réponse.
- Ignorer la thermie : la performance perçue baisse si le refroidissement n’est pas dimensionné.
- Oublier la maintenance : mises à jour, gestion des modèles, sauvegardes et contrôle des versions.
Sources et repères : ce que disent l écosystème et les organismes
Pour replacer ces annonces dans le contexte, deux repères restent utiles : la trajectoire des plateformes GPU et les cadres de l’IA embarquée. NVIDIA documente régulièrement l’évolution de ses architectures et des performances visées, via ses publications techniques récentes.
Sur l’angle “données et conformité”, des organismes comme l’NIST publient des guides liés au déploiement et à la gouvernance des systèmes IA. Ces documents aident à structurer l’évaluation du risque, même pour des traitements locaux.
Sources : NVIDIA, documentation d’architecture et analyses de performance (derniers contenus accessibles en 2024-2026) ; NIST, publications sur l’évaluation et la gouvernance des systèmes IA (mise à jour 2023-2024). Pour l’exécution locale et l’approche “privacy by design”, les travaux de recherche récents sur l’IA sur appareil restent également pertinents (2024-2025).
Ce que vous gagnez, ce que vous devez vérifier avant d y croire
La promesse centrale d’Asus repose sur l’IA locale : vous réduisez la dépendance aux services cloud et vous conservez vos données dans votre environnement. Ce modèle convient particulièrement aux usages créatifs où les fichiers et les contextes sont volumineux.
En contrepartie, la valeur dépend de critères concrets : qualité des modèles sur vos cas d’usage, durée de calcul, stabilité thermique et intégration logicielle. L’étape suivante consiste à tester vos scénarios, pas seulement les démonstrations.
| Objectif | Approche “local” via RTX Spark | Question pratique à trancher |
|---|---|---|
| Confidentialité | Traitement sans transfert systématique | Quelles données restent sur la machine, et lesquelles sortent via outils tiers |
| Temps de réaction | Réduction des délais réseau | Temps total, incluant prétraitement et itérations de génération |
| Coût | Pas de facturation “à la requête” | Capex matériel vs coût d’accès cloud sur votre volume réel |
Questions fréquentes sur RTX Spark et l IA à la maison
RTX Spark signifie-t-il que tout reste toujours hors cloud ?
Pas nécessairement. Asus évoque des modes modulables, dont un scénario de répartition via Zeny Cloud. Le principe vise surtout à limiter les transferts, mais l’implémentation dépend des paramètres et des outils utilisés.
Quels modèles peuvent vraiment tourner en local sur ces machines ?
Les annonces citent des ordres de grandeur, comme des modèles jusqu’à 120 milliards de paramètres. La performance réelle dépend du réglage du contexte, de la précision (ex. FP4) et de la taille mémoire disponible selon la tâche.
Un mini-PC comme le ProArt GR1X peut-il gérer des agents en continu ?
Asus présente le ProArt GR1X comme conçu pour fonctionner en continu, jusqu’à 140 W, avec un refroidissement optimisé. Avant adoption, validez les temps de réponse sur vos workflows et la tenue sur plusieurs heures.
Quels logiciels faut-il connaître pour exploiter RTX Spark ?
Les briques principales annoncées incluent MuseTree pour la génération locale, StoryCube pour l’indexation et Creator Hub comme tableau de bord. Les bundles listés peuvent aussi influencer votre démarrage, selon vos licences.
Quels risques doivent être évalués pour des agents qui agissent sur vos fichiers ?
Vérifiez les droits d’accès, les garde-fous et les traces d’exécution. Même en local, un agent peut modifier des données si les règles sont trop permissives. La gouvernance doit donc être pensée dès la configuration initiale.
Prochain pas : si vous envisagez une configuration RTX Spark, listez trois cas d’usage précis, puis testez le temps total, la qualité et la stabilité thermique avant de généraliser. L’IA locale prend tout son sens quand elle s’aligne sur votre réalité.
À propos des repères chiffrés : les valeurs citées ici proviennent des annonces et doivent être confirmées par des tests sur votre environnement. Pour comparer sereinement, mesurez vos temps de génération, la consommation réelle et les performances sur vos jeux de données.
Sources citées : NVIDIA (publications et documentation d’architecture, dernières mises à jour 2024-2026) ; NIST (cadres et guides de gouvernance et d’évaluation des systèmes IA, mises à jour 2023-2024).
Pour renforcer la démarche, associez ces repères à des mesures internes sur vos volumes et vos contraintes.